做商品搜索时,我首先想到的也是 Elasticsearch。不过,在增加一套搜索服务之前,我想先验证一个问题:如果商品数据已经存放在 PostgreSQL 中,需求主要是中文关键词检索、业务筛选和基础相关性排序,数据库现有的能力能否满足要求?
这次实验使用 PostgreSQL 18.6 + zhparser 2.4 + pg_trgm 1.6;
1. 先确认各组件负责什么
常被口头称为“pg_zhparser”的扩展,实际扩展名是 zhparser。
| 组件 | 本次用途 | 能力边界 |
|---|---|---|
| zhparser | 借助 SCWS 对中文文本分词 | 不负责索引维护和相关性排名 |
| PostgreSQL 内置全文检索 | 使用 tsvector 表示词项及其位置、权重;通过 GIN 加速匹配,再用 ts_rank_cd 排名 | 不会自动理解商品意图或完成业务同义词扩展 |
| pg_trgm | 基于字符三元组,支持字符串相似度和部分模式匹配查询的索引加速 | 不是中文分词器,也不是语义模型 |
安装需要区分两件事:服务器已经具备扩展文件,以及当前数据库已经启用扩展。CREATE EXTENSION 不会自动下载和编译扩展。
pg_trgm 通常由 PostgreSQL 的 contrib 模块提供;缺少文件时,需要安装与发行版、PostgreSQL 大版本相匹配的软件包。zhparser 是第三方扩展,一般需要先安装 SCWS,再进行编译。下面仅展示 Linux 下的构建流程,前提是已经准备好编译工具、PG 18 开发头文件和 SCWS 1.2.3 源码包:
# 从 SCWS 官方站获取 scws-1.2.3.tar.bz2 后执行。
tar -xjf scws-1.2.3.tar.bz2
(cd scws-1.2.3 && ./configure --prefix=/usr/local --with-pic \
  && make && sudo make install)

git clone https://github.com/amutu/zhparser.git
cd zhparser
# 编译前切换到自己验证过的 tag 或 commit;默认分支不保证对应本文版本。
make PG_CONFIG=/usr/lib/postgresql/18/bin/pg_config SCWS_HOME=/usr/local
sudo make PG_CONFIG=/usr/lib/postgresql/18/bin/pg_config SCWS_HOME=/usr/local install
pg_config 路径需要根据实际环境调整。使用 Docker 时,应将安装步骤固化到镜像中,避免容器重建后丢失扩展。托管数据库需要先确认扩展白名单;Windows 原生部署则需要匹配版本的二进制文件,不能直接照搬上述 Linux 命令。
我这次使用 Docker 搭建本地环境,并借助 AI 编程工具辅助安装和排查问题。工具可以减少重复操作,但扩展版本、安装日志和最终 SQL 结果仍然需要核对。
-- 查看服务器可用的扩展。
-- installed_version 为 NULL,表示当前数据库尚未启用该扩展。
SELECT name, default_version, installed_version
FROM pg_available_extensions
WHERE name IN ('zhparser', 'pg_trgm');

CREATE EXTENSION IF NOT EXISTS pg_trgm WITH SCHEMA public;
CREATE EXTENSION IF NOT EXISTS zhparser WITH SCHEMA public;

-- 核对已安装扩展的版本与所在 schema。
SELECT e.extname, e.extversion, n.nspname AS extension_schema
FROM pg_extension e
JOIN pg_namespace n ON n.oid = e.extnamespace
WHERE e.extname IN ('zhparser', 'pg_trgm');
下文假设扩展位于 public。IF NOT EXISTS 不会把已安装的扩展移动到指定 schema;如果实际位置不同,需要调整限定名。
2. 从单表开始:生成并维护搜索向量
① 建表并配置中文检索
先创建独立的实验 schema 和商品表,再定义中文检索配置:
CREATE SCHEMA search_single;
SET search_path = search_single, public;

CREATE TABLE search_single.products (
    id BIGSERIAL PRIMARY KEY,
    title VARCHAR(200) NOT NULL,
    subtitle VARCHAR(500),
    description TEXT,
    brand VARCHAR(100),
    is_active BOOLEAN DEFAULT TRUE,
    created_at TIMESTAMPTZ DEFAULT NOW(),
    search_vector tsvector
);

CREATE TEXT SEARCH CONFIGURATION search_single.chinese_zh
    (PARSER = public.zhparser);

-- 将以下词性映射到 simple 字典:
-- n:名词;v:动词;a:形容词;i:成语;e:叹词;l:习用语;x:未知词性。
ALTER TEXT SEARCH CONFIGURATION search_single.chinese_zh
    ADDMAPPINGFOR n, v, a, i, e, l, x WITH pg_catalog.simple;

-- 固定本次复现实验的复合分词选项,避免依赖连接原有设置。
SET zhparser.multi_short = off;
SET zhparser.multi_duality = off;
SET zhparser.multi_zmain = off;
SET zhparser.multi_zall = off;

SELECT *
FROM ts_debug('search_single.chinese_zh', '苹果 降噪 AirPods');
这里的单表包含标题、副标题、描述和品牌。
分词器负责识别文本中的词,字典负责处理分词结果。simple 字典会做小写化等处理,不会自动把“苹果”扩展成 apple。词性映射也不是越多越好:应通过 ts_debug 检查目标词的类型及最终词项,避免词已经切出来,却因为没有映射而未进入向量。
这些 SET 只影响当前连接。生成测试数据、业务写入、查询和后续重算使用的连接,都应采用一致的分词配置;在 Navicat 中另开连接,也不能假设它会继承前一个连接的设置。
② 用触发器维护向量
本次给标题设置 A 权重,副标题和品牌设置 B 权重,描述设置 C 权重。search_vector 保存的是供全文检索使用的词项、位置和权重信息,字段本身不是索引;GIN 索引需要另外创建。
CREATE OR REPLACE FUNCTION search_single.update_product_search_vector()
RETURNS trigger AS $$
BEGIN
    -- 只有文本字段均未改变,且向量已经存在时,才跳过重算。
    -- 保留 NULL 向量的补算入口,便于回填触发器创建前导入的数据。
    IF TG_OP = 'UPDATE'THEN
        IF NEW.title       IS NOT DISTINCT FROM OLD.title
           AND NEW.subtitle    IS NOT DISTINCT FROM OLD.subtitle
           AND NEW.brand       IS NOT DISTINCT FROM OLD.brand
           AND NEW.description IS NOT DISTINCT FROM OLD.description
           AND NEW.search_vector IS NOT NULL
        THEN
            RETURN NEW;
        END IF;
    END IF;

    NEW.search_vector :=
        setweight(to_tsvector('search_single.chinese_zh', coalesce(NEW.title, '')), 'A') ||
        setweight(to_tsvector('search_single.chinese_zh', coalesce(NEW.subtitle, '')), 'B') ||
        setweight(to_tsvector('search_single.chinese_zh', coalesce(NEW.brand, '')), 'B') ||
        setweight(to_tsvector('search_single.chinese_zh', coalesce(NEW.description, '')), 'C');

    RETURN NEW;
END;
$$ LANGUAGE plpgsql;

CREATE TRIGGER trg_product_search_vector
BEFORE INSERT OR UPDATE OF title, subtitle, brand, description
ON search_single.products
FOR EACH ROW EXECUTE FUNCTION search_single.update_product_search_vector();
IS NOT DISTINCT FROM 用于正确比较可能为 NULL 的字段。还需要区分“进入触发器”和“真正重算向量”:UPDATE OF 判断的是字段是否出现在 SET 列表中,即使执行 SET title = title,也会进入触发器;函数内部再判断是否有必要重算。
实验调试时可以临时加入 RAISE NOTICE '触发器执行了:表=%, 操作=%, 行ID=%', TG_TABLE_NAME, TG_OP, NEW.id;,观察触发情况,但不应在几百万行导入或回填时逐行输出消息,否则会干扰测量并增加额外开销。应用也不应直接维护 search_vector,而应让它由源文本派生。
③ 已有数据需要单独回填
这里容易遗漏一个步骤:创建触发器不会自动处理表中已有的数据。
如果先创建触发器,再通过普通 INSERT 导入数据,向量会在插入时生成;如果先用 Navicat 生成了数据,随后才创建触发器,就需要补算已有记录。还应确认导入方式没有禁用触发器。
下面只演示一个主键区间,不是对全表的完整回填:
-- 示例批次:按实际主键范围逐批推进,并逐批提交。
UPDATE search_single.products
SET title = title
WHERE id > 0 AND id <= 10000
  AND search_vector IS NULL;
这条语句会进入触发器。因为待处理记录的向量为 NULL,不会被函数中的短路判断跳过。若仅判断“文本字段有没有变化”,SET title = title 就无法完成回填。
批量处理完成后,再核对实际数据量和向量覆盖情况:
-- 大表上的精确计数也有成本,不要在每个批次结束后都全表执行。
SELECT count(*) AS total_rows,
       count(*) FILTER (WHERE search_vector IS NULL) AS missing_vectors,
       count(*) FILTER (WHERE search_vector = ''::tsvector) AS empty_vectors
FROM search_single.products;

CREATE INDEX idx_products_search_zh
ON search_single.products USING GIN (search_vector);

ANALYZE search_single.products;
NULL 向量与空向量不是同一回事。前者表示字段尚未赋值;后者可能是文本为空,或没有词项通过当前配置,需要结合原始内容和 ts_debug 排查。
这里是在实验表完成导入和回填后建索引。已有业务表如何建索引,应另行评估锁等待、磁盘空间和是否需要 CREATE INDEX CONCURRENTLY,不能直接套用实验环境的操作顺序。
对后续普通写入,源文本与向量在同一事务中更新;其他连接能否读到新结果,仍受事务提交和隔离级别影响。批量修改还会带来分词、GIN 维护、WAL 和清理成本,不能把“同步维护”理解成没有写入开销。
3. 对照截图:命中了什么,分数说明什么
① 先检查一条记录的向量
下面是单表实验中的一条记录:
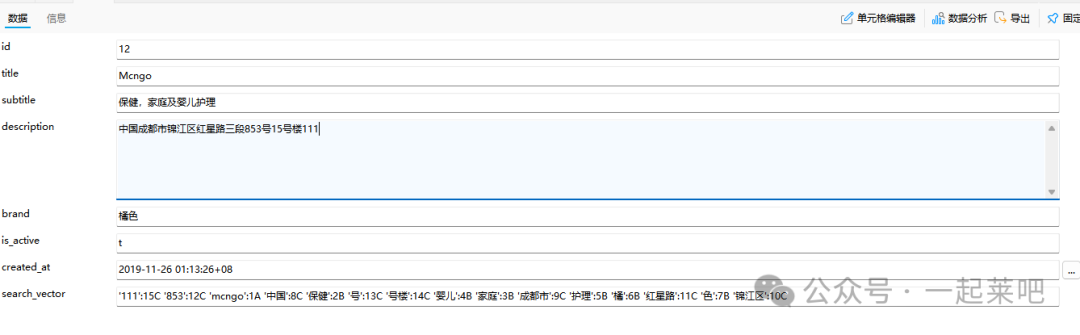
与本次查询有关的内容是:副标题包含“保健,家庭及婴儿护理”,向量中可以看到:
'婴儿':4B '护理':5B
这表示“婴儿”和“护理”已进入向量,位置分别为 4、5,权重标签都是 B。它们出现在副标题中,因此与触发器里设置的 B 权重一致。
这张截图可以用于检查该记录的向量内容。
② 区分 AND 查询与短语查询
查询前先打印实际生成的 tsquery,不要只根据输入文字判断查询语义:
SELECT
    websearch_to_tsquery('search_single.chinese_zh', '婴儿 护理') AS and_query,
    websearch_to_tsquery('search_single.chinese_zh', '"婴儿 护理"') AS phrase_query,
    websearch_to_tsquery('search_single.chinese_zh', '婴儿护理') AS unspaced_query;
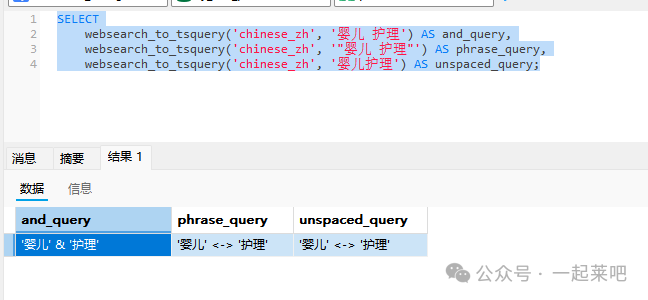
在“婴儿”“护理”都被保留为独立词项的前提下,未加引号的输入生成 AND 查询,要求两个词都出现,但不要求相邻;双引号输入生成短语查询,要求满足分词后的位置关系。本例没有中间停用词时,短语查询会使用 <->,即相邻位置。
“婴儿护理”这个无空格输入最终生成什么词项,应以当前分词器、词库和配置的实际输出为准。
③ 如何理解截图中的 0.4
ts_rank_cd 默认的 A/B/C/D 权重分别为 1.0 / 0.4 / 0.2 / 0.1。如果显式传入权重数组,参数顺序则是 D、C、B、A,不要写反。
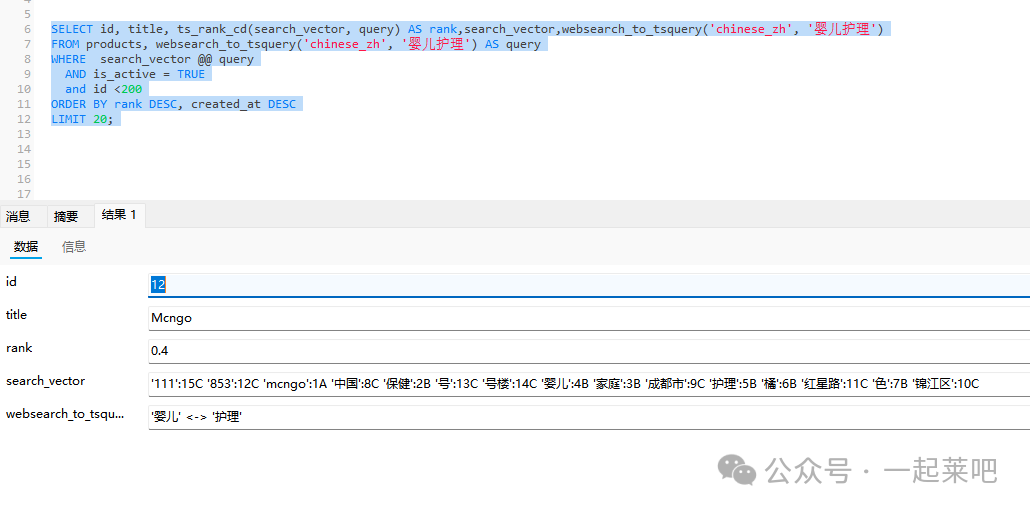
截图中,命中的“婴儿”和“护理”位置相邻,且均为 B 权重;显示的排名分数为 0.4。这一结果与该记录的命中情况相符,但不能概括成“只要命中 B 权重,分数就是 0.4”。
ts_rank_cd 使用覆盖密度排名,会考虑命中词项的位置、接近程度等信息;出现次数、权重和归一化参数也会影响结果。A 权重更高,并不意味着任何标题命中都一定排在所有其他结果之前。这个分数也不是概率,0.4 不代表“40% 相关”。
4. 用 pg_trgm 补充近似匹配
全文检索与字符串匹配处理的是不同问题。对于型号包含关系,以及接近完整标题的拼写错误,可以另外验证 pg_trgm:
-- 可选索引:先在实验环境测量体积和收益,再决定是否保留。
CREATE INDEX idx_products_title_trgm
ON search_single.products USING GIN (title public.gin_trgm_ops);

-- 型号子串匹配;返回记录取决于当前数据是否包含该型号。
SELECT id, title
FROM search_single.products
WHERE title ILIKE'%AirPods%'
AND is_active = TRUE
ORDER BY id
LIMIT 20;

-- 故意把 AirPods 写成 AirPdos,观察候选与分数。
SELECT id, title,
       public.similarity(title, '苹果 AirPdos Pro 2 蓝牙耳机') AS score
FROM search_single.products
WHERE title % '苹果 AirPdos Pro 2 蓝牙耳机'
AND is_active = TRUE
ORDER BY score DESC, id
LIMIT10;
5. 自定义词典
如果业务品牌被拆成了不合适的词项,可以进一步尝试自定义词典。例如先检查虚构品牌“声谷”的分词结果,再决定是否加入业务词。不要仅凭品牌名字推断默认分词一定正确或一定错误。
下面依据 zhparser 2.4 的自定义词表与同步函数整理。
INSERT INTO zhparser.zhprs_custom_word(word, tf, attr)
VALUES ('声谷', 100, '@')
ON CONFLICT (word)
DO UPDATE SET tf = EXCLUDED.tf, attr = EXCLUDED.attr;

-- 可选:验证停用处理。不要直接套用到生产商品语料。
INSERT INTO zhparser.zhprs_custom_word(word, attr)
VALUES ('进行', '!')
ON CONFLICT (word)
DO UPDATE SETattr = EXCLUDED.attr;

SELECT public.sync_zhprs_custom_word();
@ 是该自定义词表的默认属性,! 用于停用处理。最终词性、词项及是否进入向量,应通过 ts_debug 和 to_tsvector 确认。tf 是分词词典参数,不能把它理解为 ts_rank_cd 的加分权重,也不能仅凭设置了较高值就保证所有模式下都按整词处理。
提交词表变更并成功同步后,可断开并重建连接再验证,避免旧连接状态干扰;连接池应确认更新的是物理连接。新连接中重新设置与写入、查询一致的分词选项:
SET zhparser.multi_short = off;
SET zhparser.multi_duality = off;
SET zhparser.multi_zmain = off;
SET zhparser.multi_zall = off;

SELECT *
FROM ts_debug('search_single.chinese_zh', '声谷 进行 降噪');
SELECT to_tsvector('search_single.chinese_zh', '声谷 进行 降噪');
只有确认新分词符合预期后,才进入已有数据的向量重算阶段。修改词库不会自动改写已经存储的 tsvector,仅重建 GIN 索引也不能代替重算向量。
对于正文单表,可以按主键范围分批强制重算。例如:
-- 仅示范一个批次。源文本不变,同时把新向量置为 NULL,
-- 让 BEFORE 触发器在同一条 UPDATE 内重新生成向量。
UPDATE search_single.products
SET title = title,
    search_vector = NULL
WHERE id > 0 AND id <= 10000;
7. 到这里能得出什么结论
我的阶段性判断是:数据已经在 PG 中,且需求主要是关键词检索和结构化筛选时,可以先做一个可测量的原型;是否继续使用,应由召回质量、性能和维护成本共同决定。 如果相关性需求不断增加,或搜索明显影响交易负载,再评估独立搜索服务,而不是仅凭“少一个组件”就确定选型。
| 维度 | 本文 PostgreSQL 方案 | Elasticsearch |
|---|---|---|
| 数据维护 | 单表向量可在事务内维护; | 需要把业务数据同步到独立搜索索引,并处理同步失败、重试和核对 |
| 相关性 | 可配置字段权重,并按词项及位置排名;不等于自动获得合适的业务排序 | 默认采用 BM25,分析器、同义词及查询能力更丰富;中文分词方案仍需单独选择 |
| 资源开销 | 少部署一套服务,但分词、GIN 维护和搜索会与业务负载争用数据库资源 | 增加独立搜索服务及其容量、分片、映射和运维成本 |
| 适用判断 | 需要验证业务搜索需求能否由当前能力满足 | 需要验证新增检索能力是否值得相应的同步与运维投入 |
这次实验的价值,不在于提前宣布 PG 可以替代 ES,而在于把“能搜到”拆成可以逐项验证的问题:分词是否合适,查询语义是否一致,向量是否及时维护,以及性能是否满足业务要求。每一步有可复现的输入和输出,最终的选型结论才有依据。
#PG #PostgreSQL #分词 #全文检索 #触发器